


Von gefälschten Zitaten bis hin zu gefälschten Quellen: Der Versuch eines russischen Netzwerks, eine eigene Wikipedia für Armenien zu schaffen
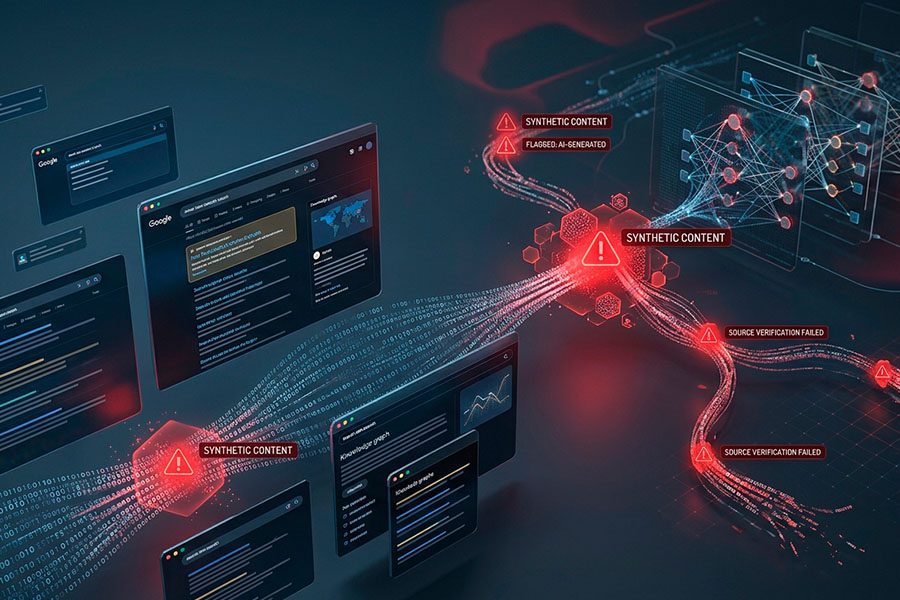
Im April 2026, nur zwei Monate vor den Parlamentswahlen in Armenien, entwickelte die russische Organisation Social Design Agency (SDA) einen Klon der Online-Enzyklopädie Wikipedia. Das Ziel des Portals, das neue Seiten automatisch erstellen sollte, beschränkte sich jedoch nicht darauf, menschliche Leser zu erreichen: Nach Recherchen der Nachrichtenagentur Bloomberg sollte das System gezielt die Suchalgorithmen von Google sowie Modelle künstlicher Intelligenz (KI) beeinflussen, die das Internet nach Informationen durchsuchen.
Die Enthüllungen basieren auf einem Bloomberg-Investigativbericht vom 24. Juni 2026, der sich auf 73 geleakte SDA-Dokumente stützt. Einige dieser Unterlagen wurden bereits zuvor von der armenischen Faktencheck-Plattform Fact Investigation Platform offengelegt. Die Dokumente belegen, dass das Projekt in Armenien Teil einer weitaus umfangreicheren Informationsoperation der SDA war.
Der Fall verdeutlicht einen Paradigmenwechsel in der Desinformation: Um Falschinformationen zu verbreiten, müssen Zielpersonen nicht mehr direkt angesprochen werden. Stattdessen wird versucht, die Quellensysteme zu manipulieren, aus denen Menschen oder KI-Systeme ihre Informationen beziehen. Ziel ist nicht nur der aktuelle Leser, sondern das gesamte Informationsangebot der Zukunft.
Das Konzept: Eine sich selbst füllende Wissensdatenbank
In einem SDA-Dokument vom 14. April wurde das Projekt für Armenien als „selbstbefüllende Wissensdatenbank“ beschrieben. Die Plattform sollte strukturell wie Wikipedia aufgebaut sein und sich fortlaufend mit neuen Artikeln aktualisieren.
Die Strategie dahinter war simpel: Es sollten Inhalte geschaffen werden, die wie gewöhnliche Nachschlagewerke wirken, gleichzeitig aber in den Suchergebnissen weit oben platziert und von Data-Scraping-Systemen leicht erfassbar sind.
Laut Bloomberg beschrieb das Projektdokument eine konkrete Methode: Die Website sollte kontinuierlich analysieren, welche Artikel am häufigsten gesucht oder gelesen werden, um auf diesen Seiten gezielt relevante Inhalte, Links und Infoboxen zu platzieren. Statt rein auf Masse zu setzen, sollten die Falschinformationen zielgerichtet dort verankert werden, wo die Wahrscheinlichkeit eines Nutzerzugriffs am höchsten war.
Die Projektplaner rechneten mit konkreten Kennzahlen: In den ersten drei Monaten sollte die Website rund 5.000 Besucher pro Tag verzeichnen, gefolgt von einem monatlichen Publikumszuwachs von 30 Prozent. Wenngleich diese Zahlen keine Garantie für den tatsächlichen Erfolg darstellen, verdeutlichen sie die Dimension des Vorhabens.
Testfeld Deutschland: Über 200.000 kompromittierte Seiten
Armenien war für die SDA kein Präzedenzfall. Eine vergleichbare „Wissensdatenbank“ wurde zuvor bereits für Deutschland betrieben. Nach internen SDA-Unterlagen umfasste dieses System Anfang 2026 bereits mehr als 200.000 Seiten. Um die Sichtbarkeit in Suchmaschinen dauerhaft aufrechtzuerhalten, sollte die Datenbank kontinuierlich aktualisiert werden.
Ein zentrales Ziel bestand auch hier darin, die Inhalte in Trainingsdaten für KI-Systeme einzuspeisen. In den Dokumenten wird unter anderem das Überarbeiten von 500 Artikeln pro Monat sowie das Training des Materials auf sechs verschiedenen KI-Plattformen explizit erwähnt.
Diese Parallelen belegen, dass das Armenia-Projekt keine isolierte Einzelinitiative war, sondern die Übertragung einer bereits in Deutschland erprobten Methode auf ein weiteres Land. Geändert wurden lediglich das Zielgebiet und die lokalen Inhalte; die Methodik – die Schaffung scheinbar seriöser Quellen zur Infiltration von Suchmaschinen und KI-Systemen – blieb identisch.
Die Rechercheergebnisse von Bloomberg
Journalisten von Bloomberg überprüften die Leaks auf ihre praktische Umsetzung. Mithilfe historischer Domain-Registrierungsdaten identifizierten sie drei Websites: spyurk.cyou, sevan.info und khachkar.info. Alle drei wurden im Januar 2026 registriert und unter derselben russischen IP-Adresse gehostet. Die Inhalte wiesen einen Bezug zu Armenien auf und waren größtenteils direkt aus der russischsprachigen Wikipedia kopiert.
Die Seiten waren jedoch nicht für menschliche Besucher optimiert, sondern leiteten diese automatisch auf andere Angebote weiter. Die Primärfunktion bestand nach Analyse von Bloomberg darin, Inhalte bereitzustellen, die von den Bots der Suchmaschinen erfasst werden können – jenen Systemen, die das Web durchsuchen, um Suchergebnisse und KI-Modelle mit Daten zu speisen.
Um die russische Herkunft zu verschleiern, sollte die Website laut Projektdokumenten in der Türkei gehostet werden. Tatsächlich wurde spyurk.cyou von einem in Delaware registrierten Unternehmen mit einer Niederlassung in der Türkei betrieben. Am 9. Juni wurden alle drei Websites vom Hosting-Anbieter ohne öffentliche Begründung abgeschaltet.
Die Infrastruktur reichte jedoch weit über diese drei Domänen hinaus. Bloomberg deckte ein größeres Netzwerk auf, darunter die Seite erevan.one sowie weitere Portale der SNG-Media-Gruppe, die mit der SDA kooperiert. Im Gegensatz zu den drei gestoppten Websites befanden sich diese Server in Russland und wiesen Verbindungen zur russischen Telekommunikationsbehörde Roskomnadzor auf. Sie blieben auch nach dem 9. Juni erreichbar.
Wichtige Einschränkung: Bloomberg betonte, dass zwischen der beabsichtigten Wirkung laut Dokumenten und dem tatsächlichen Ergebnis unterschieden werden muss. Es konnte nicht zweifelsfrei nachgewiesen werden, dass die manipulierten Inhalte tatsächlich in den Trainingsdaten großer KI-Unternehmen landeten oder Suchergebnisse maßgeblich beeinflussten. Bestätigt ist die Absicht sowie die Existenz der Infrastruktur – der reale Wirkungsgrad bleibt unklar.
Neue Taktik: Algorithmen statt Social-Media-Trolle
Der Fall markiert einen Wandel in den Methoden digitaler Einflussnahme:
[ Klassisches Trolling ]             [ Datenstrom-Infiltration ]
Ziel: Menschlicher Nutzer            Ziel: Algorithmen & KI-Modelle
Mittel: Fake-Profil / Kommentar      Mittel: Manipulierte Wissensdatenbanken
Konter: Direktes Widerlegen          Konter: Extrem schwierig (Blackbox-Problem)
Beim klassischen Trolling erfolgt die Wirkung unmittelbar über Fake-Profile oder Kommentare. Das Ziel ist eine konkrete Person, und die Falschinformation kann auf derselben Plattform korrigiert werden.
Bei der Infiltration von Datenströmen verlagert sich das Angriffsziel: Es geht nicht mehr primär um den direkten Kontakt zum Leser, sondern um die Beeinflussung der Suchmaschinen und Sprachmodelle. Ekaterina Sedova, Forscherin am Atlantic Council, bezeichnet diese Taktik als den Versuch, Suchmaschinen mit künstlich erzeugten, untereinander verlinkten Inhalten zu überfluten. Die Algorithmen stufen die mehrfache Wiederholung fälschlicherweise als Signal für Relevanz und Glaubwürdigkeit ein.
Während ein Fake-Beitrag in den sozialen Medien gemeldet und widerlegt werden kann, bleibt die Ursprungsquelle innerhalb der Trainingsdaten eines KI-Sprachmodells für den Endnutzer meist im Verborgenen. Wer eine Antwort von einem Chatbot erhält, kann in der Regel nicht nachvollziehen, aus welcher konkreten Quelle die Behauptung stammt.
Sedova weist zudem auf die Anfälligkeit von Sprachen mit kleinerer Datenbasis wie Armenisch hin. Während für die englische Sprache umfangreiche Ressourcen und Fachkräfte zur Erkennung solcher Manipulationen zur Verfügung stehen, erschwert der Mangel an Daten und Spezialisten bei kleineren Sprachräumen die Identifikation gefälschter Inhalte erheblich. Da das Gesamtaufkommen an armenischsprachigen Online-Inhalten gering ist, kann bereits eine vergleichsweise kleine Menge künstlich erzeugten Materials einen überproportional großen Platz in den verfügbaren Daten einnehmen.
Fazit: Die Methode bleibt eine Bedrohung
Jacob Rogers, Rechtsberater der Wikimedia Foundation, äußerte sich skeptisch gegenüber Versuchen dieser Art. Ohne eine große und aktive Gemeinschaft von Editoren seien solche Klone langfristig kaum lebensfähig: „Wir sehen überhaupt nicht, dass solche Klone auf Dauer Erfolg haben. Sie können Wikipedia-Inhalte eine Zeit lang reproduzieren, aber sie können sie nicht regelmäßig aktualisieren.“
Dies zeigte sich auch in Armenien: Die drei von Bloomberg identifizierten Websites überlebten nur wenige Monate, bevor sie vom Hoster abgeschaltet wurden.
Dennoch bedeutet die Schließung einzelner Portale nicht das Ende dieser Einflusstaktik. Das Weiterbestehen anderer Seiten desselben Netzwerks sowie die Existenz der großangelegten Kampagne in Deutschland belegen, dass es sich um eine langfristig angelegte Strategie handelt. Ziel ist nicht die kurzfristige Falschmeldung, sondern die systematische Verzerrung der Informationsbeschaffung durch künstlich generierte Inhalte.
Der Fall Armenien ist daher weniger als gescheitertes Einzelexperiment zu werten, sondern als Blaupause für künftige, technisch ausgereiftere Operationen. Die Löschung einzelner Websites beseitigt zwar Teile der aktuellen Infrastruktur, unterbindet jedoch nicht das zugrundeliegende Prinzip der KI- und Algorithmen-Manipulation.
Hripsime Hovhannisyan
Das Material wurde im Rahmen des Projekts zur Überwachung von Desinformationsströmen erstellt.

#CivilSocietyCooperation #ishrarmenia #ishrfactcheck
Das Projekt wird mit finanzieller Unterstützung des Auswärtigen Amtes der Bundesrepublik Deutschland durchgeführt.


Leave A Comment